
傳統資安 vs. AI 資安:威脅模型的演進
傳統資訊安全的核心奠基於確定性(Deterministic)邏輯:相同的程式碼輸入相同的資料,輸出結果必然一致。防禦手段主要依賴邊界防禦(Boundary Protection)、輸入過濾(Input Sanitization)與嚴格的角色存取控制(RBAC)。
然而,以大型語言模型(LLM)為核心的 AI 系統帶入了機率性(Probabilistic)特徵。這導致了全新的資安挑戰:
自然語言即程式碼(Text as Code):傳統系統將指令與資料(Instruction vs. Data)劃分得非常清楚(例如 SQL 語句與 SQL 參數);但在 LLM 集中式 Token 流中,指令與使用者輸入的文字混雜在一起,導致無法用傳統正則表達式或語法樹輕鬆隔離。
不可預測的邊界:LLM 具有創意的生成能力,使其攻擊面擴展到語意層面(Semantic Attacks)。攻擊者不再需要傳送畸形的 Byte 或 Shellcode,只需利用自然語言誘導(Prompt Engineering)即可繞過安全限制。
資安邊界的模糊化:LLM 往往會連結 external tools、Vector Database(向量資料庫)或內部 API。當模型被成功操控時,外部輸入便直接轉化為具有內部系統權限的指令。
AI 系統的全生命週期攻擊面(Attack Surface)
一個完整的 AI 系統主要包含四個階段,每個階段都面臨不同的資安風險: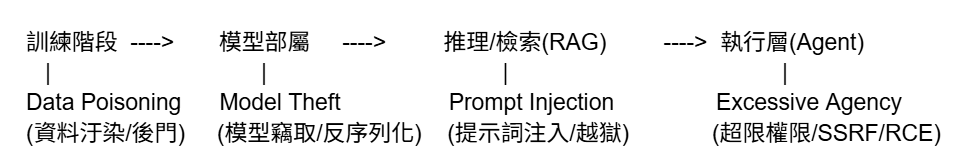
Data Poisoning:在預訓練或 Fine-tuning 階段注入惡意資料,埋入後門觸發詞(Triggers)。
Malicious Artifacts:從 Hugging Face 或 GitHub 下載未經認證的權重檔(如包含任意程式碼執行的 .pkl 或 .bin 檔案)。
Model Extraction / Theft:透過大量 API 查詢逆向工程拷貝商業模型權重。
Side-Channel & Inversion Attacks:透過 Token 產生時間、記憶體洩漏或機率分布反推訓練集的敏感資料(如 PII)。
Prompt Injection:透過直接(Direct)或間接(Indirect)輸入惡意提示詞操縱模型行為。
Indirect Poisoning via RAG:將惡意指令隱藏在網站、PDF 或向量資料庫中,待 RAG 檢索時觸發。


 iThome鐵人賽
 看影片追技術